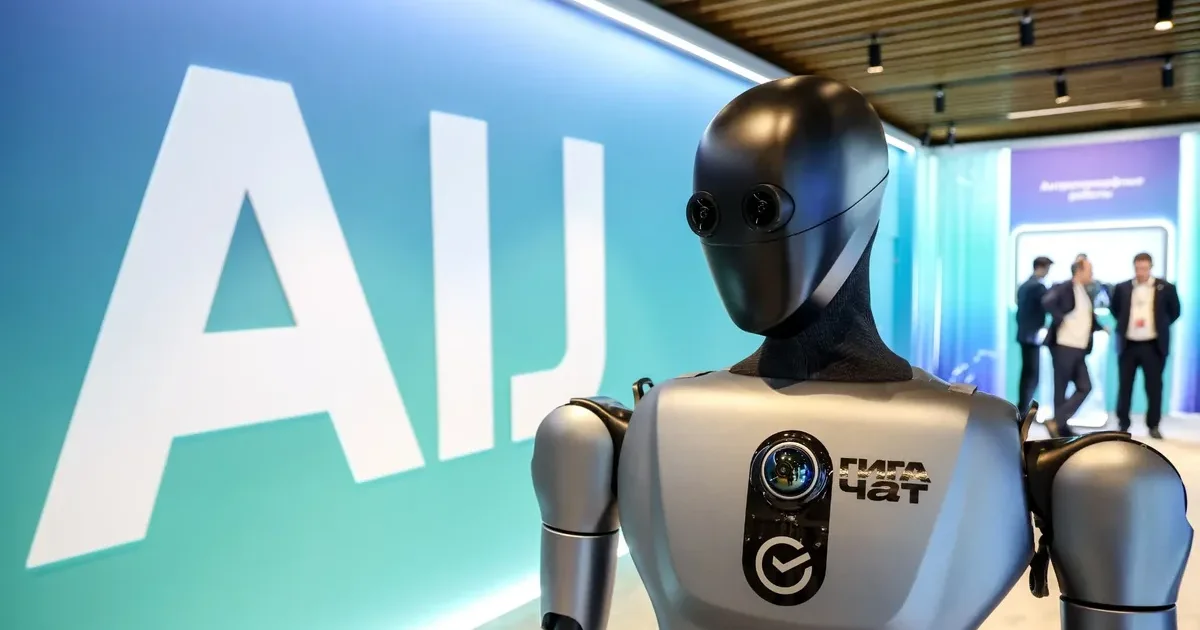
Правительство обсуждает обязательное использование суверенных моделей ИИ для бизнеса
В правительстве обсуждают законопроекты, которые обяжут бизнес использовать суверенные модели искусственного интеллекта. Пока это лишь стадия дискуссий и сбора предложений, но даже она вызывает у участников рынка откровенный скепсис.
Одни ссылаются на финансовые издержки, другие видят в этом ограничение конкуренции, однако главная проблема лежит в иной плоскости.
Для начала авторы инициатив предлагают разобраться с терминами. «Суверенной» моделью ИИ предлагается считать ту, что полностью, на всех этапах, разработана российским юрлицом и работает исключительно на инфраструктуре внутри страны.
Под это определение сейчас подпадает только GigaChat от «Сбера». «Национальная» модель должна быть существенно доработана в России, но может включать компоненты с открытым исходным кодом - как, например, Alice AI от «Яндекса».
Если с госведомствами все относительно ясно, то в случае с бизнесом ситуация резко усложняется. Выбор нейросети зависит от множества факторов, и цена здесь - один из ключевых.
Даже предложение обязать компании выбирать суверенную модель, если она не дороже национальной более чем в полтора раза, выглядит спорным. На практике оптимальным решением для предпринимателя может оказаться, скажем, китайский DeepSeek, но он автоматически окажется вне закона.
Среднему бизнесу, вероятно, безразличны эти терминологические тонкости. Его выбор часто лежит за национальными пределами, а большие универсальные модели могут быть просто бессмысленны для решения узких специфических задач.
Разбираться в хитросплетениях «суверенного» и «национального» оказывается слишком сложно и дорого.
Важно уточнить: пока все это лишь поток предложений от участников рабочих групп, где одни лоббируют инновации, а другие защищают страну. О конкретных законах говорить рано.
Однако главная претензия к происходящему уже ясна: государство снова пытается проникнуть в частную жизнь, и для бизнеса это может стать критичным - причем не только для пользователей, но и для самих разработчиков.
Конфликт заложен уже на стадии формулировок. Сегодня на рынке два лидера - «Сбер» и «Яндекс», чьи продукты имеют разную историю создания.
В итоге один оказался «суверенным», другой - «национальным». Теоретически оба термина звучат комплиментарно, но на деле обидно всем, тем более что список отечественных достижений куда длиннее.
Существуют нейросети от Т-Технологий (подразделение Т-Банка) - модели T-Lite и T-Pro, популярные в корпоративной среде. У МТС есть платформа MWS AI Agents Platform с семейством моделей Cotype, причем ее компоненты внесены в реестр российского ПО, а сама платформа - нет.
Свои разработки ведут в МФТИ (DeepPavlov) и даже в Wildberries, хотя о BerryLLM известно крайне мало.
Внутреннее устройство всех этих систем различается. Где-то используется полностью самостоятельный софт, а где-то все построено на доступных моделях с открытым кодом.
К примеру, A-Vibe от «Авито» работает на базе китайской Qwen. Это логично: желающие ворваться в ИИ-гонку используют любые доступные возможности.
На этом «Клондайке» правил нет, а скандалы с кражей данных и технологий - привычный фон.
Любая попытка жесткого регулирования неизбежно приведет к конфликту даже среди своих. Доказательство патриотичности разработки может оказаться дорогим или технически невозможным - попробуй разбери, из чего именно слеплен VoiceKit от VK.
Но продукт работает, а если начать копаться, могут всплыть подробности, которые плохо вяжутся с традиционными ценностями.
Маркеры творящегося бардака можно перечислять долго. Однако у этого торта из безумных идей есть вишенка, которая показывает: все еще сложнее.
Сегодня в мире есть признанные лидеры - OpenAI с ChatGPT, Google с Gemini, Anthropic со своим Claude, который борется за бюджеты Пентагона. Европу представляет французский Mistral, Китай - целая россыпь компаний.
Россия со своим GigaChat - полноценный участник глобальной гонки.
Но уже в следующем году все может измениться. Появятся новые игроки и технологии.
Если сейчас кажется, что без миллиардных инвестиций в вычислительные мощности на рынок не выйти, то завтра главным хитом могут стать небольшие модели, работающие прямо на устройстве пользователя. Или выяснится, что генерация ответа не требует дорогих ресурсов.
В конце концов, сегодня ИИ в прямом смысле сам себя разрабатывает, и прогнозировать его развитие - дело неблагодарное. Может статься, что не мы будем регулировать искусственный интеллект, а он нас.